Прямо сейчас, пока вы читаете этот текст, в каком-то безымянном дата-центре бот GPTBot методично индексирует очередной сайт. Без устали. Без эмоций. Рядом ползёт ClaudeBot. Чуть позади наступает PetalBot, достаточно знаменитый краулер, вышедший из недр поисковой системы Huawei. Это не художественный образ. Это буквальная картина современного интернета с 2025 года.
Зафиксировал её не очередной инфлюенсер, а Web Almanac - ежегодный проект HTTP Archive, существующий при негласной поддержке Google. Его авторы работают не с выборками и не с мнениями экспертов. Они собрали миллионы реальных сайтов и со всей их грязью, блеском и бесконечной технической бюрократией и просветили их, как рентгеновский аппарат просвечивает лёгкие.
Глава по поисковой оптимизации вышла в начале этого года. И некоторые её строки способны заставить поежиться даже тех, кто давно перестал удивляться состоянию современного веба.
Начнём с хороших новостей, потому что с них гораздо приятнее. Протокол HTTPS, тот самый замочек в адресной строке браузера, теперь стоит у более чем девяноста одного процента сайтов планеты, о которых вообще стоит говорить.
Title-теги, простейший, детсадовский элемент любой веб-страницы, стоят почти у ста процентов сайтов. Viewport meta теги, отвечающие за то, чтобы сайт вообще не разваливался на телефоне, тоже перевалили за девяносто три процента.
Это не революция. Это медленная, тектоническая, почти геологическая работа индустрии над самой собой, происходящая не потому, что миллионы веб-мастеров вдруг проснулись просветлёнными, а потому, что WordPress, Tilda, и десяток других систем управления сайтами включили эти вещи в свои настройки по умолчанию. Прогресс, оказывается, чаще приходит не от героизма, а от галочки в чекбоксе, которую кто-то однажды поставил за всех.
А вот дальше начинается настоящая, немая драма современного интернета. Треть всех страниц, каждая третья, до сих пор не имеет корректно настроенного канонического тега, той самой инструкции, которая говорит поисковику: вот эта страница главная, остальные её копии игнорируй.
Шестьдесят семь процентов изображений не имеют атрибута ленивой загрузки. Свыше девяноста одного процента фреймов вообще не имеют его настройки. Это не единичные ошибки нерадивых новичков. Это статистическая норма, фон, на котором существует буквально весь видимый интернет.
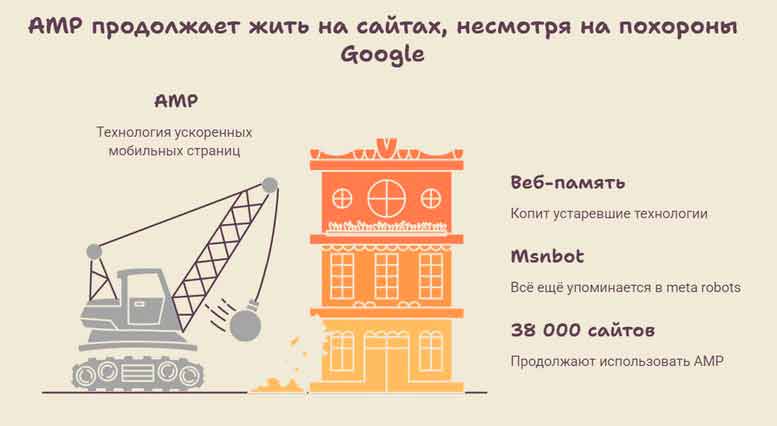
Есть в этих данных нечто почти готическое, если вглядеться. Msnbot, краулер поисковика Bing в его древней, давно замененной инкарнации, робот, официально списанный со счетов больше шестнадцати лет назад, до сих пор входит в топ-пять роботов, которых сайты явно упоминают в своих meta robots инструкциях.
Технология AMP, ускоренные мобильные страницы, проект, который Google сам фактически похоронил, тем не менее продолжает жить на тридцати восьми тысячах с лишним домашних страниц, как забытый маяк на давно необитаемом острове, всё ещё мигающий, хотя корабли давно перестали смотреть в его сторону.
Веб не забывает. Он просто копит, слой за слоем, как археологический раскоп, где верхний культурный пласт светится свежим HTTPS-замочком, а на два метра ниже до сих пор тлеют угли устаревших технологий из прошлого десятилетия.
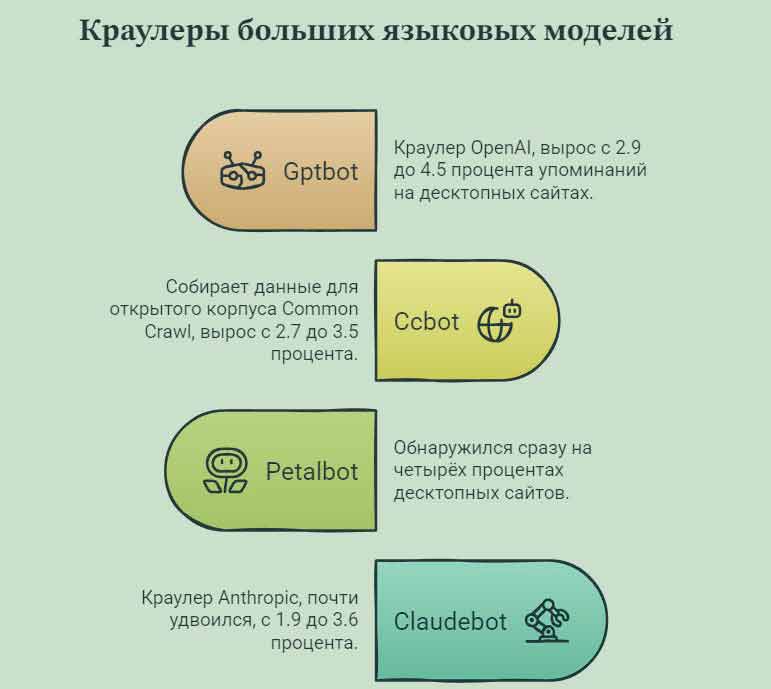
Теперь к главному, к тому самому маршу, ради которого затевался весь этот репортаж. В данных 2025 года авторы Web Almanac впервые зафиксировали в деталях, насколько глубоко в файлы robots.txt по всему интернету въелось присутствие ботов, читающих сайты не для поисковой выдачи, а для обучения и питания больших языковых моделей.
Gptbot, краулер OpenAI, за год вырос с 2.9 до 4.5 процента упоминаний на десктопных сайтах, рост почти на пятьдесят пять процентов. Ccbot, собирающий данные для открытого корпуса Common Crawl, на который потом опираются десятки других моделей, вырос с 2.7 до 3.5 процента. Petalbot, вышедший из ниоткуда для многих западных наблюдателей, обнаружился сразу на четырёх процентах десктопных сайтов. И Claudebot, краулер Anthropic, почти удвоился, с 1.9 до 3.6 процента.
Robots.txt, скромный текстовый файл, который раньше существовал лишь для того, чтобы не пускать поисковики в служебные папки сайта, за один год молча превратился в нечто иное: в документ политики, в дипломатическую ноту, которую каждый сайт теперь вынужден писать не только для Googlebot, а для целой армии моделей, читающих интернет с аппетитом, которому не знакомо чувство сытости.
Есть в отчёте и деталь, которая заслуживает отдельного абзаца просто за чистую драматургию цифр. В начале 2025 года один из авторов Web Almanac вручную прошёлся по списку из миллиона крупнейших сайтов интернета в поисках файла llms.txt, новоиспечённого, спорного стандарта, призванного облегчить языковым моделям чтение сайта. Нашёл пятнадцать штук. Пятнадцать, на миллион. Практически ничего, статистическая погрешность, шутка, а не тренд.
К концу того же года, по данным полного массива Web Almanac, файл llms.txt обнаружился уже больше, чем у двух процентов проверенных сайтов. Не революция, но ускорение, которое сам автор находки прямо назвал куда более быстрым, чем он ожидал. Почти сорок процентов этих файлов оказались там благодаря одному-единственному популярному SEO-плагину, который включил создание llms.txt по умолчанию. Опять та же история: не осознанный выбор миллионов веб-мастеров, а решение, принятое за них разработчиками одной кнопки где-то в недрах административной панели.
Джон Мюллер, тот самый Search Advocate Google, чьё слово в мире SEO цитируют примерно с той же тщательностью, с какой богословы цитировали отцов церкви, за последний год не уставал повторять одну и ту же, почти скучную по звучанию мысль: последовательность, если верить его собственной формулировке, это важнейший технический фактор SEO.
Не хитрость. Не трюк. Не секретный алгоритм, вычисленный конкурентной разведкой. Просто и буднично - последовательность.
В другом месте, отвечая на вопрос, который задают ему примерно раз в неделю на протяжении последних пятнадцати лет, не появился ли в очередной раз секретный способ обмануть поиск, Мюллер ответил с усталой прямотой человека, повторявшего одно и то же слишком много раз: в поиске нет особого фокуса, просто делайте хорошие сайты и думайте о том, что реально ищут ваши пользователи.
Скучно, если вдуматься. Но данные Web Almanac, все эти проценты, все эти армии ботов, весь этот тридцатитрёхпроцентный хаос с каноническими тегами, в сущности подтверждают ровно эту скучную мысль сильнее любого манифеста: побеждает не тот, кто нашёл лазейку, а тот, чей сайт технически последователен настолько, что ни человеку, ни роботу не приходится гадать, что на этом ресурсе вообще происходит.
У всей этой глобальной, почти геополитической драмы ботов и файлов есть вполне приземлённое следствие для владельца обычного, не самого масштабного сайта: тридцать три процента страниц интернета без канонических тегов, шестьдесят семь процентов картинок без ленивой загрузки, это не абстракция где-то там, в дата-центре, это конкретные чужие сайты, которые кто-то когда-то заказал, недоглядел и оставил вариться в собственной технической запущенности.
Студия Имагос, занимающаяся изготовлением и технической поддержкой сайтов, в описании своего подхода делает акцент на вещи, которая на языке этой самой статистики звучит почти как манифест против хаоса: фиксированная стоимость проекта, зафиксированная с самого начала и не меняющаяся в процессе работы, и принципиальная нацеленность на то, чтобы ресурс в итоге приносил клиенту деньги, а не просто существовал как красивая витрина.
В подходе к изготовлению сайтов заложена интеграция с 1С через протокол CML2, техническая деталь, звучащая сухо, но означающая на практике ровно то, о чём твердит вся эта статистика: данные должны синхронизироваться предсказуемо, без разночтений, без того самого противоречия между разными частями сайта, которое Мюллер называет корнем большинства системных сбоев, которые понижают позиции площадок.
Базовая техническая подготовка под поисковые системы, если верить описанию их работы, входит в изготовление сайта с самого начала, а не пришивается заплаткой уже после запуска, когда выясняется, что треть страниц конфликтует сама с собой. Именно в этом, если вчитаться в цифры Web Almanac, и кроется разница между сайтом, который просто есть, и сайтом, который действительно работает: не в каком-то секретном алгоритмическом трюке, а в банальной последовательности решений, принятых один раз и правильно, вместо того чтобы латать дыры годами.
|
Показатель |
2024 |
2025 |
|---|---|---|
|
Сайты с HTTPS |
- |
91%+ |
|
Title-теги |
- |
~99% |
|
Viewport meta теги |
- |
93%+ |
|
Канонические теги |
65% |
67%+ |
|
Некорректные элементы head (десктоп) |
10.6% |
10.1% |
|
Ошибки 404 в robots.txt |
14% |
13% |
|
Страницы без канонического тега |
- |
~33% |
|
Изображения без атрибута ленивой загрузки |
- |
~67% |
|
Бот |
2024 |
2025 |
Динамика |
|---|---|---|---|
|
Gptbot (OpenAI) |
2.9% |
4.5% |
+55% |
|
Ccbot (Common Crawl) |
2.7% |
3.5% |
+30% |
|
Claudebot (Anthropic) |
1.9% |
3.6% |
Почти удвоение |
|
Petalbot (Huawei) |
Не отслеживался отдельно |
4.0% |
Новая позиция |
|
Файл llms.txt (доля от топ-сайтов) |
~0.0015% (начало периода) |
~2% |
Кратный рост |
Если HTTPS и title-теги уже почти у всех, значит ли это, что базовое SEO больше не задача?
Нет, скорее это означает, что планка базового технического минимума поднялась настолько, что игнорировать его стало почти невозможно даже случайно. Проблемы теперь концентрируются в более тонких настройках: канонические теги, атрибуты загрузки изображений, согласованность разных частей сайта.
Стоит ли специально закрывать доступ ботам вроде Gptbot или Claudebot через robots.txt?
Это решение зависит от бизнес-модели конкретного сайта. Web Almanac фиксирует сам факт роста активности этих ботов и того, что robots.txt стал документом с более широким назначением, а не даёт универсальной рекомендации разрешать или запрещать доступ.
Нужен ли сайту файл llms.txt прямо сейчас?
Однозначного ответа пока нет даже у специалистов, эффективность файла остаётся предметом споров. Рост его использования в основном объясняется тем, что популярные SEO-плагины стали предлагать его создание одной кнопкой, а не осознанным выбором каждого отдельного веб-мастера.
Почему устаревшие технологии вроде AMP или msnbot до сих пор встречаются в данных?
Веб меняется медленнее, чем кажется со стороны. Изменение однажды внедрённых настроек часто требует ресурсов, времени или просто внимания, которого у владельцев многих сайтов попросту нет, поэтому старые следы годами остаются нетронутыми.
Что значит связка между внутренней разметкой сайта и заявлением Мюллера про "последовательность"?
Речь о том, чтобы разные технические сигналы сайта, навигация, канонические теги, структурированные данные, контент, не противоречили друг другу. Когда сайт присылает поисковику противоречивые сообщения о том, какая версия страницы главная, алгоритму приходится гадать, а гадание редко работает в пользу сайта.
Может ли сайт, сделанный на конструкторе вроде Tilda или WordPress, быть технически не хуже сложной индивидуальной разработки?
Данные Web Almanac показывают, что многие базовые технические стандарты сегодня действительно достигаются просто за счёт настроек CMS по умолчанию. Но более тонкие, специфичные для бизнеса технические решения, вроде корректной интеграции с внешними системами или последовательной структуры каталога, чаще требуют осознанной работы, а не автоматики.
Утром следующего дня, и ещё через день, и ещё через год, Gptbot, Claudebot, Petalbot и десятки других краулеров, чьи имена большинство пользователей интернета никогда не узнает, продолжат ползти по миллиардам страниц, безразличные к тому, обновил ли кто-то в очередной раз свой канонический тег.
Империя роботов, о которой идёт речь в этом тексте, не рушится и не завоевывается в один день. Она просто медленно, страница за страницей, становится тем, чем ее сделали миллионы мелких, скучных, почти незаметных технических решений. Иногда правильных. Чаще нет.
Источник: Web Almanac 2025, глава "SEO", HTTP Archive; Chris Green, "SEO in 2026: Higher standards, AI influence, and a web still catching up", Search Engine Land, 2026.
*